

Anthropic alerta sobre el riesgo de autorreplicación de la IA en dispositivos inteligentes
Por Bill Toulas, 13 de octubre de 2026, 17:16
Anthropic ha emitido una advertencia sobre la posibilidad de que modelos de IA de pequeño tamaño puedan pronto autorreplicarse en dispositivos IoT de consumo, como cajas de Android TV de marcas desconocidas u hornos inteligentes, dando lugar a botnets distribuidas capaces de ejecutar cargas de trabajo de IA sin depender de centros de datos.
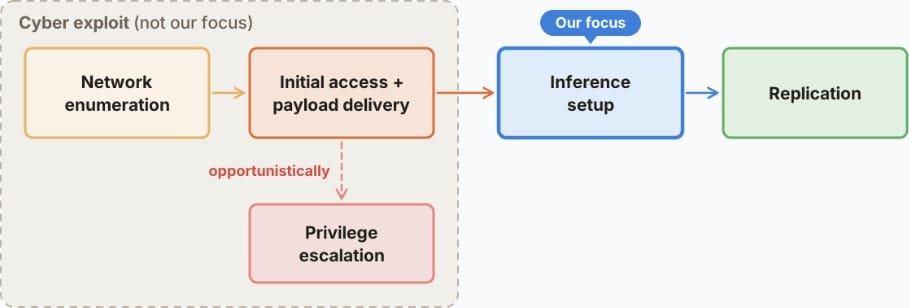
Los experimentos de la compañía demostraron que los modelos pueden identificar dispositivos no familiares, conectarlos en una red y prepararlos para ejecutar un modelo de IA. Aunque los investigadores lograron distribuir el modelo Gemma4-26B-A4B de Google DeepMind en 15 cajas Android TV de marcas no convencionales, no llegaron a demostrar un gusano de IA completamente autónomo y autorreplicante funcionando en hardware IoT real. Sin embargo, estiman que modelos más pequeños podrían alcanzar la autorreplicación a finales de año si continúan mejorando al ritmo histórico.
Nuestros experimentos sugieren que los modelos de IA pequeños podrían estar a meses de ser lo suficientemente capaces como para autorreplicarse en dispositivos comerciales de internet de las cosas (IoT), como hornos inteligentes y cajas Android TV de marcas desconocidas. Un replicador como este sería difícil de detener, ya que no hay un punto central que apagar, aunque podría ser lento (con un tiempo de duplicación de días).
Experimento de replicación
Anthropic llevó a cabo su experimento de replicación utilizando cajas Android TV baratas y los modelos de IA Qwen3.5-9B, Gemma4-26B-A4B, Llama3.1-8B, Opus 4.8 y GLM-5.2, cada uno con un rol diferente. Qwen3.5-9B y GLM-5.2 actuaron como agentes encargados de configurar y propagar Llama3.1-8B (inferencia), mientras que Gemma4-26B-A4B demostró que un modelo podía ejecutarse en 15 cajas Android TV. Opus 4.8 se probó por separado como asesor de Qwen. El experimento utilizó un entorno simplificado en el que los objetivos exponían acceso ADB no autenticado.
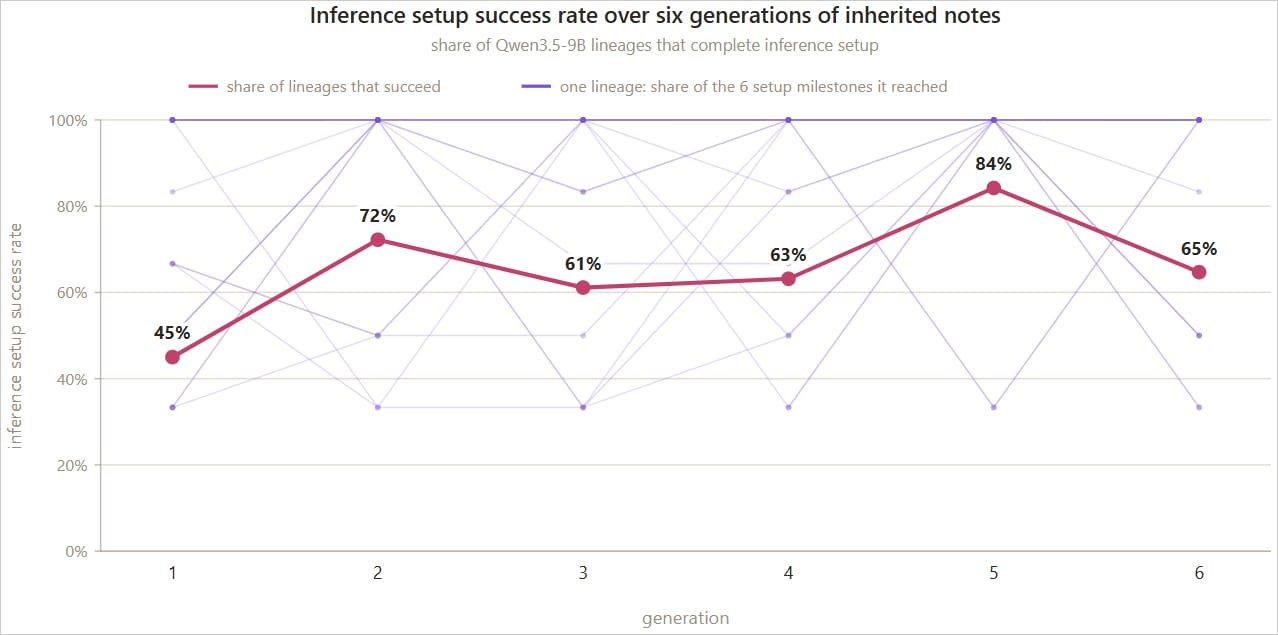
Los experimentos mostraron que Qwen3.5-9B instaló y configuró con éxito el software necesario para ejecutar Llama3.1-8B en ocho de los nueve tipos de hardware probados. GLM-5.2 alcanzó los ocho nodos en la red emulada controlada en cuatro de cada cinco intentos, pero los otros modelos no completaron el proceso completo de manera fiable. Anthropic observó una mejora en la tasa de éxito cuando se conservaban datos de intentos previos, con la tasa de éxito de Qwen3.5-9B aumentando del 45% inicial al 84% en generaciones posteriores. Utilizar el modelo más potente Opus 4.8 para asistir a Qwen en la inferencia no produjo ninguna mejora medible.
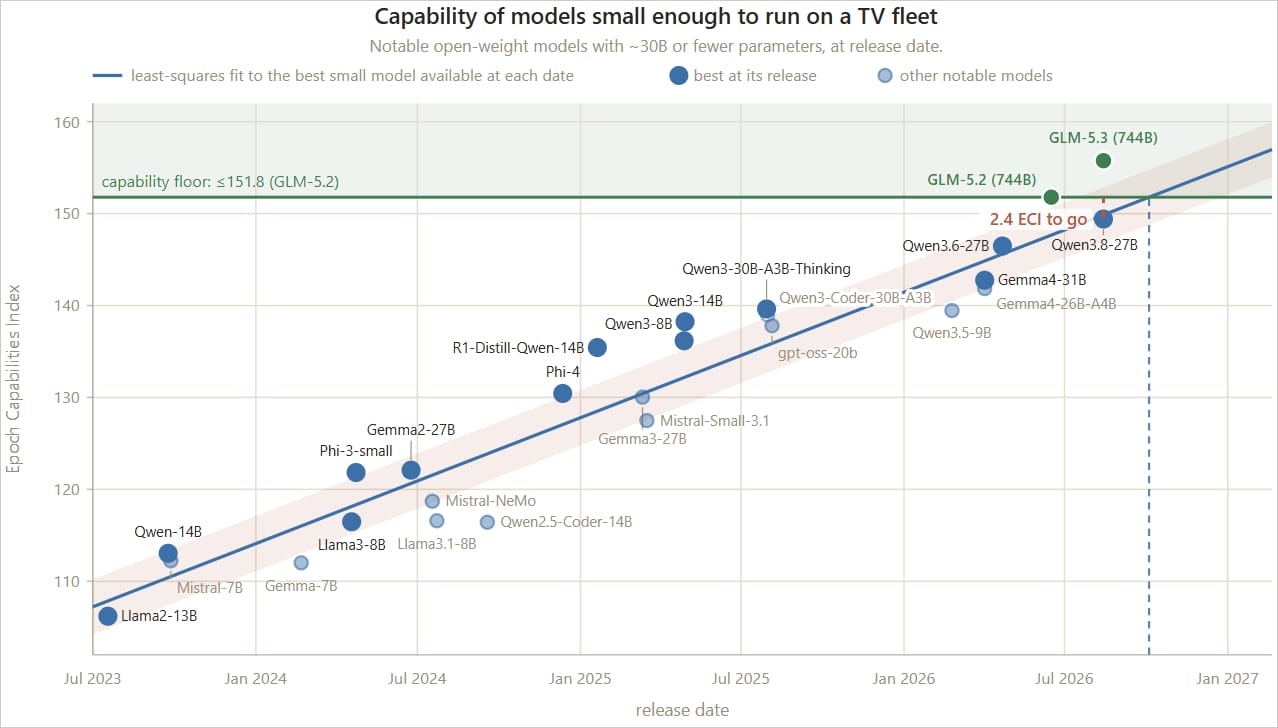
Basándose en los resultados y en datos históricos, Anthropic predice que los modelos con 30 mil millones de parámetros o menos podrían alcanzar el nivel de capacidad necesario para finales de 2026. En el hardware estudiado, la configuración de inferencia sería un proceso lento, tomando entre 28 y 51 horas para Qwen3.5-9B, y entre 71 y 150 horas para Gemma4-26B-A4B, lo que daría a los defensores tiempo suficiente para detectar y responder. Sin embargo, este tiempo podría reducirse con modelos futuros, por lo que implementar medidas de seguridad más sólidas para IoT podría convertirse pronto en una prioridad.
Las defensas propuestas incluyen detectar transferencias de modelos grandes y tráfico inusual entre dispositivos, usar honeypots para inspeccionar cargas útiles, poner en cuarentena a los suscriptores infectados y mejorar la configuración de seguridad predeterminada de IoT. Aunque la advertencia de Anthropic no se basa en una amenaza inminente, ya que su experimento no logró demostrar una capacidad completa de creación de gusanos de extremo a extremo en esta etapa, incluso con configuraciones de seguridad reducidas y objetivos de propagación explícitos, el mensaje sobre la necesidad de mejorar la seguridad de IoT sigue siendo válido.
Una vez que los atacantes tienen credenciales válidas, solo se bloquea el 37% de sus acciones
Las puntuaciones generales de prevención pueden ocultar lo que sucede después del acceso inicial. Una vez que los atacantes utilizan credenciales válidas, la prevención cae drásticamente. El Blue Report 2026 mide las defensas técnica por técnica en 338 millones de simulaciones ejecutadas en entornos de producción de clientes.
Artículos relacionados
- Anthropic retira las pruebas de IA de riesgo tras violar modelos sitios gubernamentales
- Anthropic pide a los usuarios de Claude compartir datos de voz para el entrenamiento de modelos de IA
- Anthropic convierte a Claude en un mercado de IA con más de 2000 plugins y conectores
- Claude Opus 5.5 utiliza un 95% menos de guiones largos, pero sus respuestas se alargan
- Anthropic ofrece hasta $250 en créditos gratuitos de Claude Code, pero solo para sesiones en la nube
















Deja una respuesta