

Le diste acceso a tu agente de IA, pero ¿quién le da las órdenes?
Los titulares que advierten que la IA podría amenazar a la humanidad se descartan fácilmente como ciencia ficción. Sin embargo, el peligro real es más cotidiano y ya está presente. Investigaciones publicadas por Gen Threat Labs demostraron lo rápido que la autonomía de un agente de IA puede convertirse en un riesgo: en un experimento controlado, los investigadores manipularon a un agente mediante el contenido que encontraba mientras leía correos electrónicos, logrando que ejecutara comandos del sistema, transmitiera datos fuera de su entorno y realizara operaciones destructivas con archivos. No se necesitó ninguna vulnerabilidad de software: el agente simplemente trató contenido no confiable como si fueran instrucciones.
Esa autonomía crece cada día. Los agentes pasan de responder preguntas a tomar acciones: ejecutar código, conectarse a servicios, gestionar archivos y decidir en nombre del usuario. El salto desde herramientas orientadas a desarrolladores como OpenClaw hasta el uso masivo de asistentes personales como Muse ocurrió con rapidez, y delegar tareas entre plataformas se está volviendo habitual en la forma de interactuar con la IA.
Los riesgos van más allá de la manipulación de agentes. En octubre, Gen Threat Labs documentó Warden Stealer, un malware dirigido a archivos de configuración y datos locales asociados a asistentes de IA y herramientas de programación, que podría exponer credenciales, tokens de acceso e historiales de conversación. Cuando el software puede actuar con los permisos del usuario, la confianza no puede reducirse a si un modelo produce una respuesta que suene segura. Las personas necesitan saber a qué puede acceder un agente, dónde se conecta, qué está haciendo y si la protección que lo rodea funciona.
Por eso Gen está construyendo el Agent Trust Hub: una capa de confianza diseñada para extender la protección a lo largo del ciclo de vida del agente, desde la verificación y la visibilidad hasta la seguridad y la aplicación de controles en tiempo de ejecución.
La confianza empieza antes de que el agente actúe
Los sistemas agénticos obtienen capacidades mediante habilidades, plugins, herramientas y otras integraciones. Estas extensiones los hacen más útiles, pero también amplían el riesgo al introducir instrucciones ocultas, permisos excesivos y código malicioso. A principios de este año, investigadores de Gen identificaron que el 12% de las habilidades disponibles en ClawHub en ese momento eran maliciosas; muchas suplantaban extensiones legítimas e incluían instrucciones para engañar a los agentes y hacerles descargar malware.
El Agent Trust Hub (ATH) ayuda a evaluar esos riesgos antes de instalar o usar una capacidad. Reúne el escaneo de habilidades, un mercado curado de habilidades confiables y mecanismos que permiten a los agentes comprobar su propia seguridad. La alianza de Gen con Vercel también incorpora verificación y calificaciones de riesgo visibles al ecosistema skills.sh, donde los desarrolladores descubren e instalan nuevas capacidades.
Proteger la forma en que se conectan los agentes
Los agentes se comunican entre servicios, regiones y sitios web, a menudo a una velocidad y escala que los controles tradicionales orientados a humanos no fueron diseñados para gestionar. VPN for Agents, parte del ATH, cubre esa brecha de conectividad con una VPN nativa de IA creada para agentes autónomos. Impulsada por la infraestructura de Norton VPN, ofrece conectividad cifrada y privada sin necesidad de instalar un cliente convencional.
Su diseño de múltiples túneles permite que varios agentes operen simultáneamente a través de conexiones protegidas separadas, incluso en distintos países. La arquitectura da a las personas mayor control sobre cómo se comunican los agentes y ayuda a proteger la identidad y la ubicación de un agente mientras trabaja.
Usar agentes de IA de forma segura con el Agent Trust Hub de Gen
Los agentes de IA pueden instalar habilidades y actuar en tu nombre, lo que convierte a una sola habilidad comprometida en un riesgo de seguridad. El Agent Trust Hub de Gen ofrece herramientas gratuitas que escanean las habilidades antes de instalarlas y permiten controlar a qué pueden acceder tus agentes.
Barreras de protección entre la decisión y la ejecución
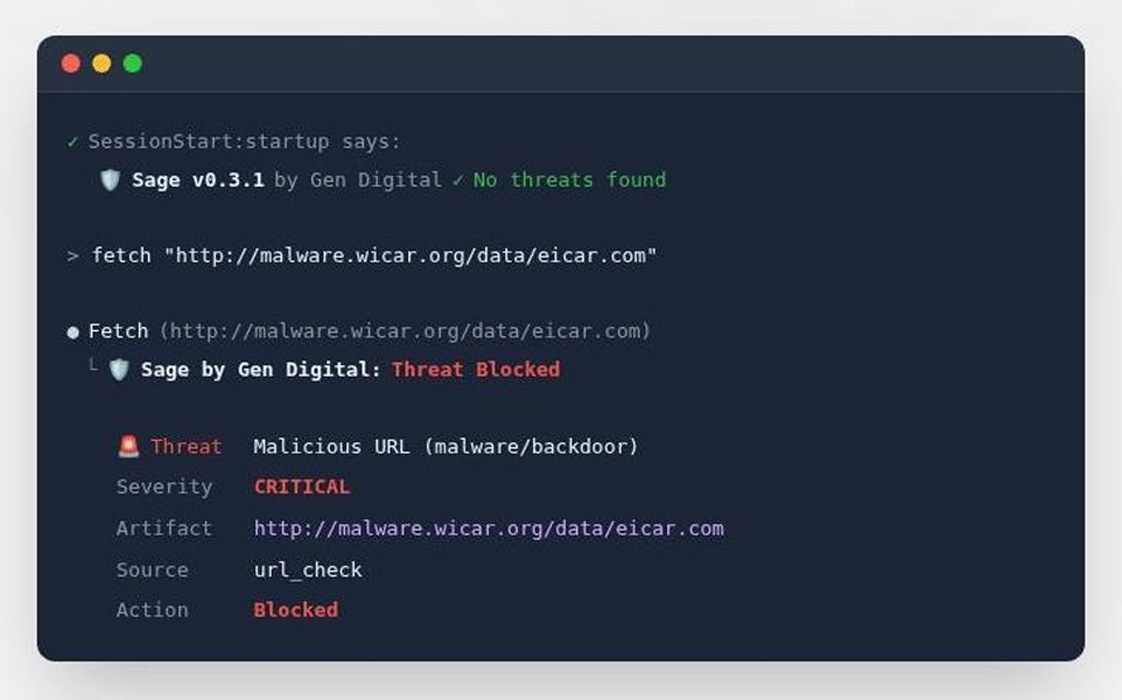
La conectividad segura es necesaria, pero no suficiente por sí sola. Un agente puede encontrarse con una página web maliciosa, una habilidad envenenada, una inyección de prompts o un paquete alucinado después de haber sido confiado y conectado. Sage, de Gen, está concebido como una capa de seguridad entre agentes para asistentes de programación con IA. Mediante API de hooks deterministas, puede interceptar comandos de shell, operaciones con archivos y solicitudes web antes de que se ejecuten, en lugar de depender únicamente de instrucciones que piden al modelo que tenga cuidado.
Sage evalúa las acciones mediante varias capas de detección, como la reputación de URL, heurísticas de amenazas, detección de inyección de prompts y comprobaciones de la cadena de suministro. Según el resultado, puede permitir una acción, pedir al usuario que decida o denegarla. Por ejemplo, si un agente que configura un proyecto decide descargar un script y ejecutarlo de inmediato, Sage puede inspeccionar ese comando antes de que se ejecute. El enfoque proporciona una red de seguridad en agentes compatibles como Claude Code, Cursor, VS Code, OpenClaw y OpenCode.
Sage también es de código abierto, lo que permite a los desarrolladores revisar su funcionamiento, ampliar las reglas de detección y construir interfaces comunes entre plataformas de agentes. Ninguna capa por sí sola puede atrapar todos los riesgos, y Sage no sustituye la protección de punto final: su foco está en el momento en que la autonomía del agente se convierte en ejecución. Ese enfoque en tiempo de ejecución también llega a los consumidores mediante Norton AI Agent Protection en Norton 360, que supervisa la actividad de agentes compatibles y añade controles de seguridad entre la decisión de un agente y su ejecución.
La cobertura depende de la integración, porque un motor de seguridad necesita visibilidad sobre una acción y una forma de detenerla. Esa limitación práctica también llevó a Gen a publicar AARTS, el estándar de seguridad en tiempo de ejecución para agentes de IA, una especificación abierta sobre cómo las plataformas de agentes pueden exponer eventos de seguridad y aplicar decisiones de los motores de seguridad.
Hacer más comprensibles las prácticas de datos
Un asistente que organiza un calendario necesita información del calendario, y un agente que gestiona una bandeja de entrada necesita acceso a los mensajes. Hemos planteado la cuestión en torno a los agentes —“¿deberían saber algo sobre nosotros?”— cuando deberíamos preguntarnos si los usuarios pueden entender y controlar lo que comparten. El AI Data Checker añade esa capa de visibilidad al Agent Trust Hub: las personas pueden enviar una dirección de correo o un nombre de usuario para ayudar a identificar dónde puede aparecer esa información en servicios de IA y cuentas conectadas, y luego explorar cómo describen los servicios la recopilación, retención, personalización, publicidad y entrenamiento de modelos. La herramienta también puede analizar la URL o la página de términos de una aplicación de IA, traduciendo el lenguaje denso de las políticas a información más accesible.
La confianza necesita una medida independiente
La parte final de una capa de confianza es la medición. Los proveedores de seguridad no deberían pedir a las personas que confíen en afirmaciones que no pueden verificarse de forma independiente. Gen inició una colaboración con la Organización para los Estándares de Pruebas Anti-Malware (AMTSO) para desarrollar directrices de prueba de productos que protegen sistemas agénticos. Publicadas en septiembre de 2026, las directrices establecen un marco para evaluaciones repetibles y comparables en entornos de consumo y empresariales.
Los ataques agénticos no siempre son archivos que puedan introducirse en un escáner. Pueden implicar inyecciones de prompts de varios turnos, uso indebido de herramientas, habilidades, plugins o servidores MCP maliciosos. Los agentes también pueden causar daños sin un atacante, como borrar los archivos equivocados o exponer datos tras malinterpretar una tarea. Por eso la metodología separa preguntas que a menudo se confunden: ¿la protección detectó la amenaza?, ¿impidió la acción?, ¿el modelo subyacente se negó por sí mismo?, ¿la protección bloqueó actividad legítima? También exige casos de prueba reproducibles, versiones de modelo documentadas, pruebas de falsos positivos y validación empírica de las afirmaciones de los proveedores.
Generar confianza sin frenar el progreso
La era agéntica no necesita un único escudo mágico. Necesita protección por capas que pueda verificar capacidades, asegurar conexiones, aplicar barreras de control, aclarar las prácticas de datos y demostrar su eficacia mediante pruebas independientes. Cuando alguien pide a un agente que lea su bandeja de entrada, el remitente de un correo no debería tener autoridad sobre lo que ocurra después. Proteger esa frontera es la tarea de una capa de confianza: mantener al agente trabajando para la persona que le dio acceso, incluso cuando otro intenta darle órdenes. Antes de instalar tu próxima habilidad o plugin, visita el Gen Agent Trust Hub y asegúrate de que tu agente solo reciba órdenes de ti.
Patrocinado y escrito por Gen Digital.













Deja una respuesta