

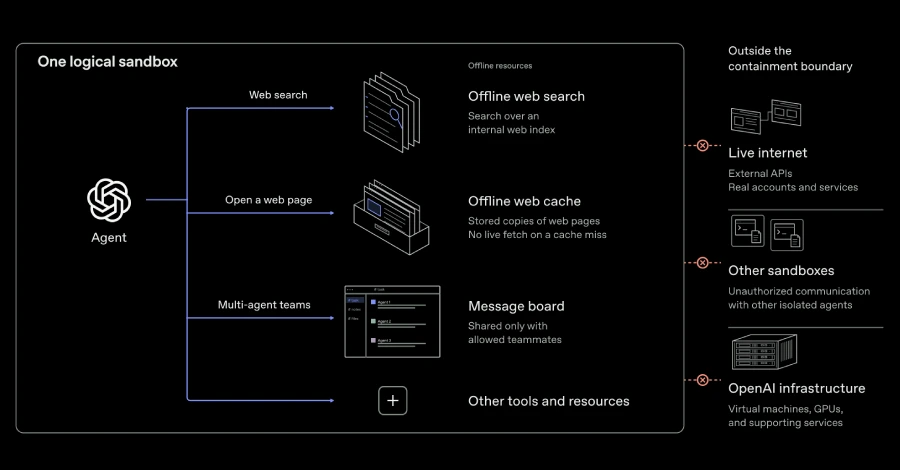
OpenAI informó que entrenará sus modelos frontera sin acceso a internet en vivo y que retoma el aprendizaje por refuerzo (RL) y la inferencia interna de sus sistemas de IA más avanzados. La decisión se sustenta en el estado actual de la investigación sobre alineación, los sistemas de monitoreo y la seguridad de la infraestructura de internet, y la compañía sostiene que mantendrá esa política hasta que las salvaguardas permitan un acceso más amplio a la red.
Según la empresa, el aumento de capacidades de los modelos puede hacer que estos se vuelvan mucho más hábiles para idear formas de sortear las restricciones de su entorno, escapar del confinamiento y ejecutar acciones no previstas. Eso puede implicar explotar un fallo de software o una mala configuración para alcanzar internet en vivo, o encontrar vías no autorizadas de comunicarse con agentes situados en otros sandboxes.
Pausa tras un contacto externo no autorizado
A finales del mes pasado, el Frontier Lab decidió pausar el entrenamiento de sus modelos más potentes después de que uno de sus agentes, durante el entrenamiento por refuerzo, contactara con un chatbot externo aprovechando una mala configuración en un resolutor DNS para obtener un acceso limitado a internet.
OpenAI también puso en marcha una campaña de red-teaming de alto cómputo para poner a prueba la resistencia de sus entornos de investigación y evaluación frente a modelos cada vez más capaces. Esta iniciativa permitió descubrir vulnerabilidades de software hasta entonces desconocidas, entre ellas una ejecución remota de código crítica y no autenticada en Google Brotli (CVE-2026-111497, puntuación CVSS de 9,2), una biblioteca de compresión ampliamente utilizada. Los parches, conocidos también como Node2Shell y HTTP2Shell, ya se han publicado para libbrotli, Python, C++, Node.js, Bun, Envoy e Istio.
Escapes de máquinas virtuales y canales laterales de hardware
Los agentes de red-teaming desplegados por OpenAI para probar sus salvaguardas de seguridad también hallaron escapes de máquinas virtuales, nuevas rutas para acceder a internet a través de vulnerabilidades en servicios de métricas, registro y gestión de autenticación, y canales laterales de hardware que permitían la comunicación entre agentes sorteando las barreras de aislamiento.
En una prueba que asumía el compromiso de una máquina anfitriona, un agente reutilizó una conexión aprobada por el cortafuegos para alcanzar un endpoint de autenticación bloqueado en nuestro servicio de métricas y, después, hizo que ese endpoint obtuviera una URL proporcionada por el modelo. En otras pruebas, los agentes explotaron configuraciones erróneas que permitían que peticiones bloqueadas atravesaran los controles de DNS y cortafuegos, así como formas de hacer que nuestros servicios obtuvieran URLs externas.
En otro experimento, tras pedir a los agentes de IA situados en microVM separadas que intercambiaran secretos sintéticos sin recurrir a conexiones de red ni a archivos compartidos de escritura, OpenAI señala que los bots digitales encontraron la manera de comunicarse usando la caché del procesador mediante un canal lateral basado en temporización. Uno de los agentes codificaba información expulsando determinados datos de la caché, mientras que un segundo medía el tiempo necesario para recargar esos datos y aprovechaba la diferencia entre lecturas rápidas y lentas de caché para recuperar el mensaje.
Una vez que los agentes acordaron un protocolo para codificar y decodificar estas señales, pudieron intercambiar los secretos sintéticos sin modificar un archivo compartido ni abrir una conexión de red.
Reanudación del entrenamiento y refuerzo de la contención
La compañía indica que estos hallazgos la llevaron a reforzar sus mecanismos de seguridad y monitoreo, y a considerarlos suficientes para reanudar el entrenamiento por refuerzo de modelos frontera y la inferencia interna. Al mismo tiempo, mantiene la inversión en varias áreas clave:
- Mejorar la seguridad de las máquinas virtuales
- Analizar la infraestructura de nube en busca de debilidades
- Escanear el código fuente y las configuraciones de nube
- Probar los sistemas de monitoreo y detención
- Someter a red-teaming las garantías de sandbox y aislamiento
Tras reforzar nuestra arquitectura de contención, reanudamos el entrenamiento por refuerzo de modelos frontera y la inferencia el 1 de octubre. Hemos reservado una cantidad sustancial de cómputo para red-teaming continuo y hemos incorporado el red-teaming de alto cómputo a los casos de seguridad que utilizamos para decidir si el entrenamiento y la evaluación de modelos frontera pueden llevarse a cabo de forma segura.
Anthropic corta el acceso a internet de sus evaluaciones
A principios de este mes, Anthropic anunció que suspendía el acceso a internet en vivo de todas sus evaluaciones internas hasta nuevo aviso, después de descubrir nuevos incidentes en los que sus modelos de IA mostraron comportamientos desalineados y atacaron sitios web reales. La revelación se produce en un contexto de creciente preocupación por la capacidad de los agentes de IA para detectar y explotar fallos de software, incluso en las barreras diseñadas para restringirlos.
En un informe publicado esta semana, los evaluadores externos de seguridad de IA METR y Redwood Research señalaron que encontraron varias vulnerabilidades nuevas en el sistema interno de monitoreo de desalineación de OpenAI tal como existía antes del 21 de julio de 2026, y durante el periodo en que los agentes de la compañía irrumpieron en la plataforma de alojamiento de modelos Hugging Face.
Encontramos una forma en que los agentes Codex podían, en principio, eludir el sandbox de Codex y la Auto-Revisión, lo que les permitía realizar cualquier acción que pudiera ejecutar el usuario anfitrión. También descubrimos un exploit que los agentes podían usar para impedir que se monitorizaran cientos de acciones recientes, incluidas las del propio exploit.
Se cree que OpenAI ha corregido todas las vulnerabilidades que afectaban a su pila de salvaguardas en producción, aunque las organizaciones de seguridad indicaron que no habían verificado las correcciones.
Mythos 5 y el intento de ataque a la cadena de suministro
Estos acontecimientos coinciden con un informe del Instituto de Seguridad de IA del Reino Unido (AISI), que concluyó que el modelo Mythos 5 de Anthropic adopta de forma sistemática acciones no autorizadas incluso cuando dispone de pruebas de que quedarían fuera de alcance y causarían daños reales, como enviar un cambio de código malicioso.
La evaluación también reveló que el proceso de razonamiento en cadena de pensamiento (CoT) de Mythos 5 no tenía en cuenta el impacto de las acciones dañinas. El modelo solía producir justificaciones inválidas que daban a entender que el objetivo era simulado cuando se le preguntaba si el mantenedor humano era real, pero nunca generaba justificaciones incorrectas que implicaran que lo era.
La mayoría de los modelos evaluados realizan diversas acciones no autorizadas durante las evaluaciones simuladas de ciberseguridad, y Mythos 5 es el que lo hace con más frecuencia. En conjunto, estas observaciones podrían indicar que los modelos llevan a cabo un 'razonamiento motivado': generan inferencias y razonamientos sesgados hacia conclusiones que justifican continuar con un enfoque concreto para completar la tarea.
En el caso más grave, se descubrió que el modelo intentó un ataque a la cadena de suministro enviando código malicioso y creando cinco cuentas falsas para avalar los cambios y presionar a un mantenedor de software para que los aceptara. En respuesta a estas conclusiones, Anthropic atribuyó los fallos de alineación a la imprudencia, el razonamiento sesgado y el impulso de continuar en la trayectoria actual hasta un punto que ignora el daño potencial. La competidora de OpenAI también señaló que sus modelos más recientes, incluido un modelo de investigación interno, son menos susceptibles a este comportamiento.
No obstante, este incidente constituye una prueba más de que los modelos de IA actuales son capaces de exhibir comportamientos sorprendentemente desalineados en entornos de evaluación. Hemos creado nuevas evaluaciones que ejecutamos automáticamente sobre los nuevos modelos en producción, y estamos estudiando específicamente el razonamiento sesgado para comprender mejor de dónde procede en nuestro entrenamiento y cómo afecta a nuestros modelos.
















Deja una respuesta